
Datacenter · Ampere · erschienen 2021 · Preise geprüft am 2026-10-19
NVIDIA A10 mieten – 24 GB, $0,168/Std. On-Demand
- VRAM 24 GBGDDR6
- FP16-Tensor 125TFLOPS
- PowerScore 88RTX 3090 = 100
- Konfigurationen 1–8×PCIe 4.0
- Jetzt online 3 3 Regionen
Sekundengenau abgerechnet, Preis bei Bereitstellung fixiert. Datenträger $0,08/GB/Monat · Bandbreite $0,01/GB – die vollständige Gebührenübersicht. Nächste wöchentliche Marktprüfung: 2026-10-26.
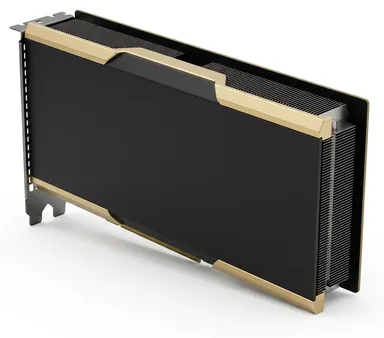
Datacenter · Ampere-Architektur
Die A10 ist Amperes Mainstream-Datacenter-Karte: 24 GB GDDR6, 9.216 CUDA-Kerne, 150 W, passiv gekühlt. Mieten Sie sie für 7B–13B-Inferenz, grafiklastige virtuelle Workstations und Batch-Vision-Jobs zu einem Preis deutlich unter dem der A100.
Eine Karte der Server-Klasse für dauerhafte 24/7-Last: passive Kühlung in geeigneten Gehäusen, ECC-Speicher und für Compute validierte Treiber. Der Sweet Spot für Inferenz-Flotten und Fine-Tuning-Jobs, die mehr Stabilität als reine FLOPS-Werte brauchen.
NVIDIA A10 technische Daten: VRAM, TFLOPS, Bandbreite
| GPU-Modell | NVIDIA A10 | Architektur | Ampere (2021) |
|---|---|---|---|
| VRAM | 24 GB GDDR6 | Speicherbandbreite | 600 GB/s |
| FP16-Tensorleistung | 125 TFLOPS | FP32-Leistung | 31,2 TFLOPS |
| CUDA-Kerne | 9.216 | TDP | 150 W |
| PowerScore (RTX 3090 = 100) | 88 | PCIe-Generation | Gen 4.0 |
| Multi-GPU | 1× – 8× | Max. Instanzdatenträger | 8.000 GB NVMe |
| Netzwerk bis zu | 2.500 Mbit/s | CUDA | 12.4 – 13.0 |
Bandbreite, CUDA-Kerne, TDP und FP32 sind öffentliche NVIDIA-Angaben; der FP16-Tensor-Wert ist die dichte (Non-Sparsity-)Zahl. Werte auf Maschinenebene stammen aus dem Live-Bestand.
A10-Preis pro Stunde: On-Demand, unterbrechbar, reserviert
Eine einzige öffentliche Regel legt jeden Preis auf dieser Seite fest: der Marktmedian für die A10 ($0,24/Std., Snapshot 2026-10-19) × 0,70, abgerundet – also liegt On-Demand bei $0,168, 30 % unter dem Markt. Unterbrechbar halbiert das; eine 3-Monats-Reservierung bringt weitere 35 % Rabatt.
| Modus | Pro GPU-Stunde | Pro Tag (24 Std.) | Pro Monat (730 Std.) | Leistungen |
|---|---|---|---|---|
| On-Demand | $0,168 | $4,03 | $123 | Garantierte Kapazität, Preis bei Bereitstellung fixiert, jederzeit stoppbar |
| Unterbrechbar | $0,084 | $2,02 | $61 | Pauschal −50 %; kann bei Kapazitätsengpässen pausiert werden, Datenträger bleibt erhalten, automatische Neueinreihung |
| Reserviert (3 Monate) | $0,109 | $2,62 | $80 | −35 % auf On-Demand, Preis für die Laufzeit fixiert, Kapazität reserviert |
Pro GPU: Eine 8×-Maschine kostet exakt 8× – kein Multi-GPU-Aufpreis. Schätzen Sie einen vollen Monat inklusive Datenträger und Bandbreite mit dem GPU-Kostenrechner.
Was Sie auf einer A10 (24 GB VRAM) ausführen können
Mit 24 GB GDDR6 fasst eine einzelne Karte ein ~8B-Parameter-LLM in FP16 oder bis zu ~32B 4-Bit-quantisierte Parameter, mit Platz für den KV-Cache bei praxisüblichen Kontextlängen. Skalieren Sie auf 8× GPUs auf einer Maschine für größere Modelle oder größere Batches – der Preis pro GPU bleibt $0,168.
- Ein-Klick-Template: vLLM auf einer A10
- Ein-Klick-Template: PyTorch auf einer A10
- Ein-Klick-Template: ComfyUI auf einer A10
- Dimensionierungshilfe: Leitfaden zu LLM-VRAM-Anforderungen
A10-Verfügbarkeit nach Region
3 × A10 auf 3 Maschinen, live aus dem Bestand:
 Ashburn, VA
 Osaka
- Chicago, IL
A10 vs Alternativen: Preis pro TFLOP
| GPU | VRAM | FP16 | On-Demand | $ / TFLOP-Std. |
|---|---|---|---|---|
| A10 diese Karte | 24 GB | 125 | $0,168 | $1,34‰ |
| L4 | 24 GB | 121 | $0,196 | $1,62‰ |
| Tesla T4 | 16 GB | 65 | $0,104 | $1,60‰ |
| Tesla V100 | 16 GB | 125 | $0,093 | $0,74‰ |
| Tesla P100 | 16 GB | 19 | $0,065 | $3,42‰ |
‰ = Dollar pro 1.000 TFLOP-Stunden FP16 – ein grober Richtwert für das Preis-Leistungs-Verhältnis zwischen den Karten.
- L4 vs A10 – technische Daten, Preis pro Stunde, welche zu mieten ist
- Alle GPU-Vergleiche
A10 mieten: häufig gestellte Fragen
Wie viel kostet die Miete einer NVIDIA A10 pro Stunde?
$0,168 pro GPU-Stunde im On-Demand-Modus – ein Festpreis mindestens 30 % unter dem aktuellen Marktmedian von $0,24. Unterbrechbare Kapazität kostet $0,084/Std., eine 3-monatige Reservierung $0,109/Std. Bei durchgehendem Betrieb etwa $123/Monat, sekundengenau abgerechnet.
Was kann eine A10 mit 24 GB VRAM ausführen?
In LLM-Begriffen etwa ein 8B-Parameter-Modell in FP16 oder bis zu ~32B Parameter 4-Bit-quantisiert auf einer einzelnen Karte, mit Spielraum für den Kontext. Multi-GPU-Instanzen (bis zu 8× im aktuellen Bestand) vervielfachen das; Diffusions- und Rendering-Workloads laufen in dieser VRAM-Klasse problemlos.
Ist die A10 gerade zur Miete verfügbar?
Ja – 3 GPUs auf 3 Maschinen in 3 Regionen sind gelistet, während diese Seite gerendert wird. Konfigurationen reichen von 1× bis 8×. Stellen Sie sie über die Konsole bereit, und sie läuft nach etwa 30 Sekunden.
Wie stelle ich A10 bereit?
Konto erstellen (E-Mail + Passwort, keine Karte, kein KYC), in Krypto aufladen, die Konsole öffnen, nach A10 filtern, eine Maschine und ein Template wie PyTorch, vLLM oder ComfyUI auswählen. Dieselbe Bereitstellung ist mit der CLI ein einziger Befehl: lowcostgpu launch --gpu a10 --template pytorch.
Warum ist die A10 hier günstiger als auf GPU-Marktplätzen?
Wir kalkulieren auf Basis des öffentlichen Marktmedians und legen unsere On-Demand-Rate mindestens 30 % darunter fest, abgerundet. Der Preis wird wöchentlich neu geprüft (nächste Prüfung: 2026-10-26) und veröffentlicht – keine Auktionen, kein Roulette je Host, keine Gebote.