
Datacenter · Ada Lovelace · sortie en 2023 · prix vérifiés 2026-10-19
Louez un GPU NVIDIA L4 — 24 GB, $0,196/h à la demande
- VRAM 24 GBGDDR6
- FP16 tensor 121TFLOPS
- PowerScore 85RTX 3090 = 100
- Configurations 1–4×PCIe 4.0
- En ligne actuellement 10 4 régions
Facturé à la seconde, prix verrouillé au déploiement. Stockage $0,08/GB/mois · bande passante $0,01/GB — toute la grille tarifaire. Prochaine revérification hebdomadaire du marché : 2026-10-26.
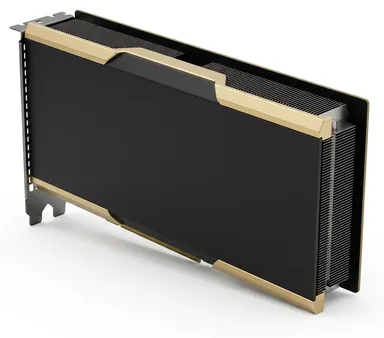
Datacenter · architecture Ada Lovelace
La L4 est la carte d’inférence efficace : 24 GB GDDR6 pour seulement 72 W, mono-slot, Tensor Core Ada et deux moteurs NVENC/NVDEC. C’est le bon choix à louer pour les pipelines de transcodage vidéo, les API de petits modèles et les embeddings par lots, quand la consommation et le prix comptent plus que le pic de FLOPS.
Une carte de classe serveur conçue pour une charge continue 24 h/24 et 7 j/7 : refroidissement passif dans un châssis adapté, mémoire ECC, et pilotes validés pour le calcul. Le choix indiqué pour les flottes d’inférence et les tâches de fine-tuning qui recherchent la stabilité plus qu’un chiffre de FLOPS impressionnant.
Caractéristiques NVIDIA L4 : VRAM, TFLOPS, bande passante
| Modèle de GPU | NVIDIA L4 | Architecture | Ada Lovelace (2023) |
|---|---|---|---|
| VRAM | 24 GB GDDR6 | Bande passante mémoire | 300 GB/s |
| Perf. FP16 tensor | 121 TFLOPS | Perf. FP32 | 30,3 TFLOPS |
| Cœurs CUDA | 7 680 | TDP | 72 W |
| PowerScore (RTX 3090 = 100) | 85 | Génération PCIe | Gén. 4.0 |
| Multi-GPU | 1× – 4× | Stockage maximal de l’instance | 8 000 GB NVMe |
| Réseau jusqu’à | 10 000 Mbps | CUDA | 12.4 – 13.0 |
Bande passante, cœurs CUDA, TDP et FP32 sont des chiffres publics NVIDIA ; FP16 tensor est le chiffre dense (hors sparsité). Les valeurs au niveau machine proviennent de l’inventaire en direct.
Prix par heure de la L4 : à la demande, interruptible, réservé
Une règle publique fixe chaque prix sur cette page : la médiane de la place de marché pour le GPU L4 ($0,28/h, snapshot 2026-10-19) × 0,70, arrondie à l’inférieur — donc le prix à la demande est $0,196, 30 % sous le marché. L’interruptible le réduit de moitié ; une réservation de 3 mois retire 35 % de plus.
| Mode | Par GPU-heure | Par jour (24 h) | Par mois (730 h) | Ce que vous obtenez |
|---|---|---|---|---|
| À la demande | $0,196 | $4,70 | $143 | Capacité garantie, prix verrouillé au déploiement, arrêt à tout moment |
| Interruptible | $0,098 | $2,35 | $72 | −50 % fixe ; peut être mise en pause en cas de pression sur la capacité, disque conservé, remise en file automatique |
| Réservé (3 mois) | $0,127 | $3,05 | $93 | −35 % sur le prix à la demande, tarif bloqué pour la durée, capacité réservée |
Par GPU : une machine à 4× coûte exactement 4× — aucun surcoût multi-GPU. Estimez un mois complet avec le stockage et la bande passante dans le calculateur de coût GPU.
Ce que vous pouvez exécuter sur une L4 (24 GB de VRAM)
Avec 24 GB de GDDR6, une seule carte contient un LLM de ~8B paramètres en FP16 ou jusqu’à ~32B paramètres quantifiés en 4 bits, avec de la place pour le cache KV à des longueurs de contexte réalistes. Passez à 4× GPU sur une même machine pour des modèles plus grands ou des batches plus grands — le prix par GPU reste $0,196.
- Template en un clic : vLLM sur une L4
- Template en un clic : PyTorch sur une L4
- Template en un clic : ComfyUI sur une L4
- Aide au dimensionnement : guide des besoins en VRAM pour les LLM
Disponibilité de la L4 par région
10 × L4 sur 4 machines, en direct depuis l’inventaire :
 São Paulo
 Montréal
 Amsterdam
 Francfort
L4 vs alternatives : prix par TFLOP
| GPU | VRAM | FP16 | À la demande | $ / TFLOP-h |
|---|---|---|---|---|
| L4 cette carte | 24 GB | 121 | $0,196 | $1,62‰ |
| A10 | 24 GB | 125 | $0,168 | $1,34‰ |
| Tesla T4 | 16 GB | 65 | $0,104 | $1,60‰ |
| Tesla V100 | 16 GB | 125 | $0,093 | $0,74‰ |
| L40 | 48 GB | 181 | $0,318 | $1,76‰ |
‰ = dollars par 1 000 TFLOP-heures de FP16 — une estimation approximative du rapport valeur/calcul entre les cartes.
- L4 vs Tesla T4 — caractéristiques, prix par heure, laquelle louer
- L4 vs A10 — caractéristiques, prix par heure, laquelle louer
- Toutes les comparaisons de GPU
Louer une L4 : questions fréquentes
Combien coûte la location d’un GPU NVIDIA L4 par heure ?
$0,196 par GPU-heure à la demande — un prix fixe, au moins 30 % sous la médiane actuelle du marché de $0,28. La capacité interruptible coûte $0,098/h et une réservation de 3 mois $0,127/h. Environ $143/mois si vous la laissez tourner sans interruption, facturée à la seconde.
Que peut faire un GPU L4 avec 24 GB de VRAM ?
En termes de LLM, environ un modèle de 8B paramètres en FP16, ou jusqu’à ~32B paramètres quantifiés en 4 bits sur une seule carte, avec de la marge de contexte. Les instances multi-GPU (jusqu’à 4× sur l’inventaire actuel) multiplient cela ; les charges de diffusion et de rendu tiennent confortablement dans cette classe de VRAM.
Le GPU L4 est-il disponible à la location dès maintenant ?
Oui — 10 GPU sur 4 machines dans 4 régions sont répertoriés au moment où cette page est générée. Les configurations vont de 1× à 4×. Déployez depuis la console, et elle tourne en environ 30 secondes.
Comment déployer un GPU L4 ?
Créez un compte (e-mail + mot de passe, sans carte, sans KYC), rechargez en crypto, ouvrez la console, filtrez par L4, choisissez une machine et un template comme PyTorch, vLLM ou ComfyUI. Le même déploiement tient en une commande avec la CLI : lowcostgpu launch --gpu l4 --template pytorch.
Pourquoi le GPU L4 est-il moins cher ici que sur les places de marché de GPU ?
Nous établissons nos prix à partir de la médiane de la place de marché publique et fixons notre tarif à la demande au moins 30 % en dessous, arrondi à l’inférieur. Le prix est revérifié chaque semaine (prochaine vérification : 2026-10-26) et publié — pas d’enchères, pas de roulette par hôte, pas de surenchère.